用 Kavita 整理电子书阅读入口:Docker 部署、书库类型与原文件保留
部署 Kavita 电子书库,核对镜像目录、资料类型、阅读状态和原文件,验证恢复。
文章目录
电子书目录整理得很整齐,阅读时却仍要先下载、找应用,再回忆上一次读到哪里。Kavita 可以把自己有权使用的电子书、漫画和相关资料组织成网页书库,提供阅读界面与用户入口,适合把经常看的内容集中放在一处。
先准备少量代表文件,而不是直接导入整个资料盘。一份 EPUB、一份 PDF 和一个常用漫画系列,就能发现目录、识别与阅读上的基本问题。文件扩展名相同,内容结构也可能差很多,软件支持格式不等于每个文件都可正确解析。
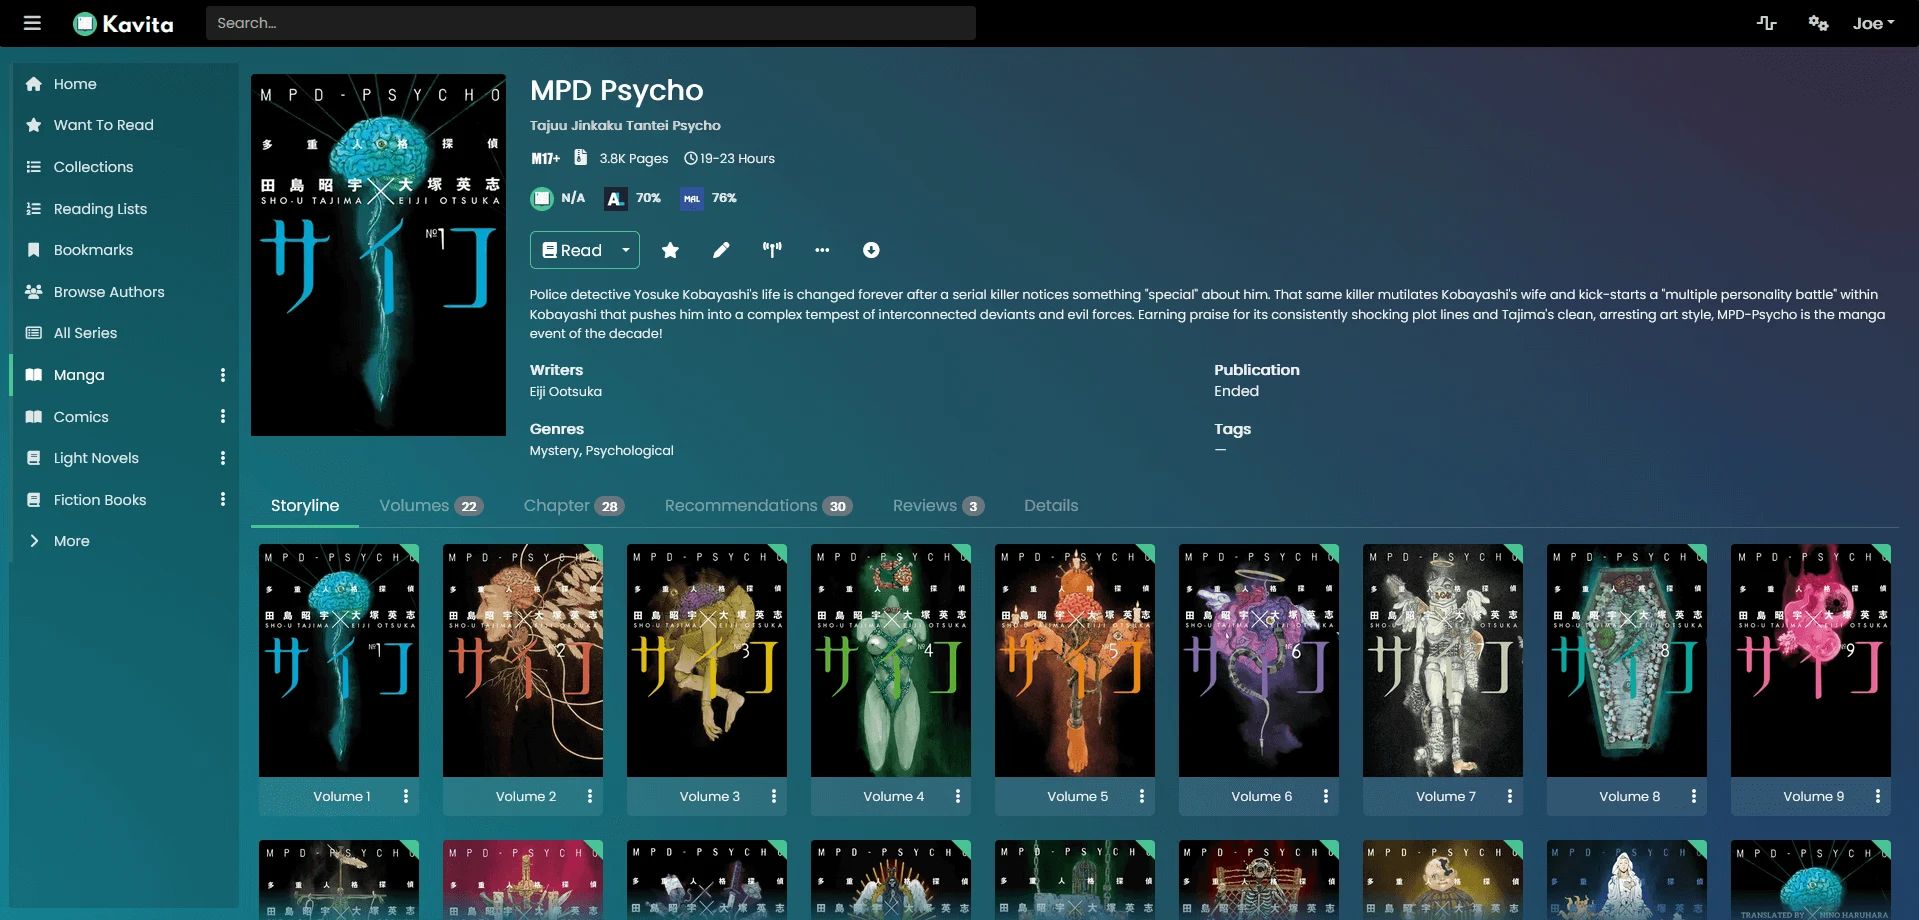
官方示例展示系列详情、卷册与章节入口。外部评分等附加功能可能需要 Kavita+,具体以当前版本和授权为准。自己的书库仍要核对顺序、文字和阅读状态。
部署前先确认 VPS 的磁盘、内存和公网访问条件,也可以查看雨云云服务器;注册时填写优惠码 KuZhuJi。
官方镜像的配置目录是固定路径
本文采用 jvmilazz0/kavita,它的持久配置挂载到 /kavita/config。其他发行镜像可能采用不同路径,不能仅因为都叫 Kavita 就混用目录。书籍可以放到自己指定的挂载点,再在界面中填写容器内路径。
mkdir -p ~/services/kavita/config ~/services/kavita/books
cd ~/services/kavita
保存 compose.yaml:
services:
  kavita:
    image: jvmilazz0/kavita:latest
    environment:
      TZ: Asia/Shanghai
    ports:
      - "127.0.0.1:5010:5000"
    volumes:
      - ./config:/kavita/config
      - ./books:/books:ro
    restart: unless-stopped
本例书籍只读挂载,用于扫描与阅读。需要上传、写入原文件或其他会修改书库的功能时,另行核对当前版本的目录与权限要求,不把所有挂载直接改成可写。
官方把这里的 latest 列为稳定发行通道,nightly 是测试新功能的分支。Nightly 的数据不一定能立即回到旧稳定版本,正式资料库不要为了尝鲜跨过去。首次验收后固定实际版本或镜像摘要。
docker compose config --quiet
docker compose up -d
docker compose logs --tail=100 kavita
ssh -L 15010:127.0.0.1:5010 user@your-server
本机打开 http://127.0.0.1:15010,按首次启动界面建立管理员。这个入口只供私人初始化,需要远程设备使用时,HTTPS 代理连接宿主机 5010,再检查登录和阅读请求。
一种资料先建一个合适的书库
把样本放在 books 下,界面中填写 /books 或相应子目录,而不是宿主机的 ~/services/kavita/books。书库类型影响识别与展示,先根据实际内容选择,不把 EPUB、漫画和杂乱扫描文件无差别扔进一个目录。
扫描结束后检查系列名、卷数、章节和封面。文件名里的数字与元数据可能共同影响识别,先拿一个系列调整命名,再决定是否批量修改。原文件最好留有独立副本,便于回看修改前的状态。
如果一本书不出现,先看格式、目录与扫描日志。损坏压缩包、重复文件或元数据异常都有可能,反复点击扫描不会修复原件。拿一份已知可用的小样本对照,能更快缩小问题范围。
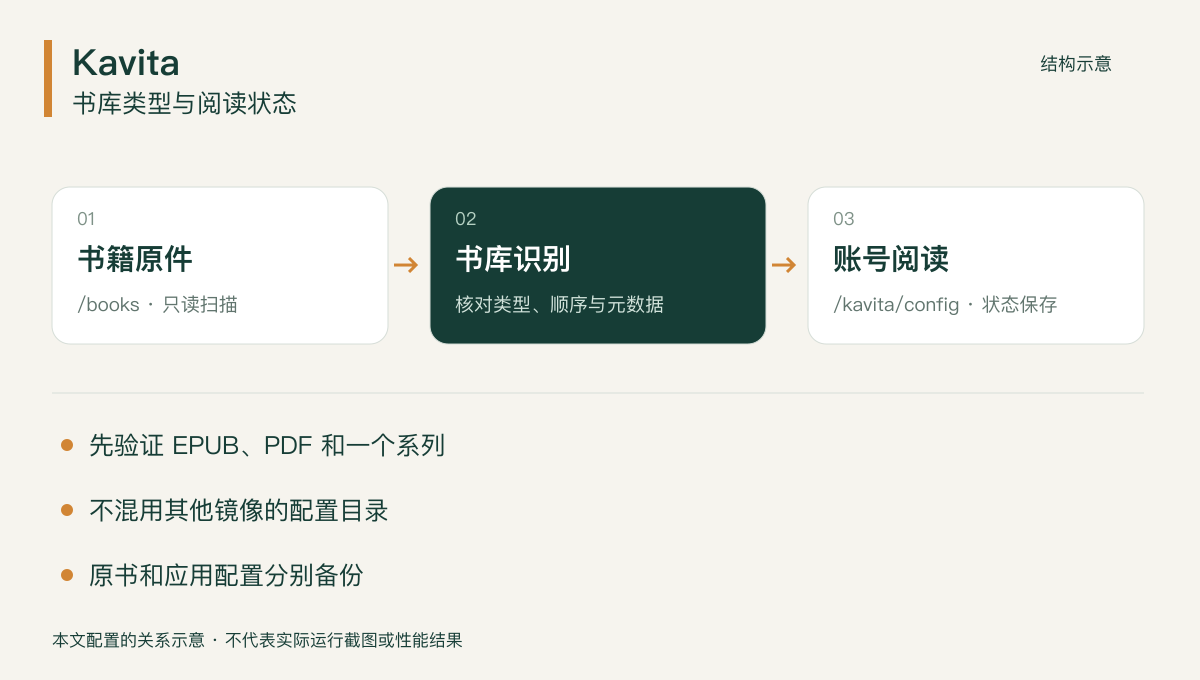
原文件承载书籍内容,应用配置承载账号及相关状态。两者分别保存,才有机会恢复同一套阅读入口。
准备独立实例时,可在雨云选择适合的云服务器配置,优惠码 KuZhuJi。配置按实际任务选择,数据库和附件另做备份。
EPUB 与 PDF 用不同方式验收
EPUB 重点核对章节目录、文字、中文字体与图片。更改字号或阅读主题后翻到中间,检查是否仍能定位。固定版式的书与普通可重排正文体验不同,不把同一套设置强加给每份文件。
PDF 重点看页数、页面方向、文字清晰度与连续翻页。扫描件与带文本层的 PDF 具有不同结构,搜索、复制文字的效果不能一概而论。书库的检索功能也不意味着所有扫描内容都已经做过 OCR。
漫画先核对阅读方向与页序。文件名中的补零、卷号或特殊后缀,可能改变整理结果。手机与桌面分别试几页,确认缩放和页面切换符合自己的阅读习惯。
普通用户与管理员分开使用
管理员用于书库配置和维护,日常阅读建立普通账号。多人使用时,每人有自己的凭据与阅读状态,再按当前权限功能限制可见书库。不要为了省一步设置,让所有人共享管理员。
用账号 A 阅读样本,在另一设备登录同一账号核对进度;再用账号 B 打开,确认没有混入 A 的状态。只在同一浏览器标签内刷新,不能充分检查跨设备保存。
给外部阅读器使用 OPDS 或其他接口时,按当前官方支持方式配置。网页能读不代表每个客户端都支持同样格式、认证或进度同步;客户端只负责下载的情况下,阅读记录可能保存在它自己那里,先实际验证。
需要增加服务器时,可以打开雨云选购页面,填写优惠码 KuZhuJi;迁移前保留数据与原有部署配置。
文件移动前保留可对照的路径
扫描后的目录不要随手大规模改名。先复制一个测试系列,观察当前版本怎样处理移动、重命名和重复,再改正式书库。记录旧路径和新路径,避免同一本书在几个地方出现后无法解释。
新增资料可以分批扫描,关注磁盘余量及任务日志。封面、缓存和数据库也会占用空间,不能只按书籍原件的体积估算。与正式网站同机时,首次扫描安排在可观察的时段,不根据未经测量的配置承诺处理速度。
应用提供阅读入口,但不是原始资料的唯一保存地点。自己制作的电子书还需保留编辑源文件和导出版本;从别处获得的资料,也只保存和分享自己有权使用的内容。
恢复时同时检查文件与状态
小样本演练可以暂停应用后打包配置与书籍:
mkdir -p backups
docker compose stop kavita
tar -czf "backups/kavita-$(date +%F-%H%M%S).tar.gz" config books compose.yaml
docker compose start kavita
大型原书库按自己的备份方式另存,副本转移到服务器之外。恢复使用独立目录和原版本,检查账号、书库类型、章节顺序、阅读及进度。升级后若数据已经迁移,回退应恢复升级前的配置,不只换回旧镜像。